
社内の情報を探すために、SharePoint、Google Drive、チャットツール、CRM、社内ポータルなどを何度も行き来していませんか。
企業では、部門や業務ごとに異なるシステムが利用されており、必要な情報が複数の場所に分散しがちです。その結果、過去の提案資料が見つからない、同じ質問が繰り返される、担当者しか情報の所在を知らないといった課題が発生します。
こうした問題を解決する手段として注目されているのが、エンタープライズ 検索(エンタープライズサーチ)です。
近年は、キーワード検索に加えて、AIによる意味検索やRAG(検索拡張生成)を活用し、複数の社内システムから関連情報を探して回答する仕組みも広がっています。
ただし、企業向け検索システムを導入する際には、検索精度だけでなく、データ連携、アクセス権限、情報の更新、セキュリティなども考慮する必要があります。
本記事では、エンタープライズ検索の仕組み、AIを活用した社内横断検索の構成、導入手順、費用、評価方法を解説します。
エンタープライズ検索の仕組みと従来の社内検索との違い
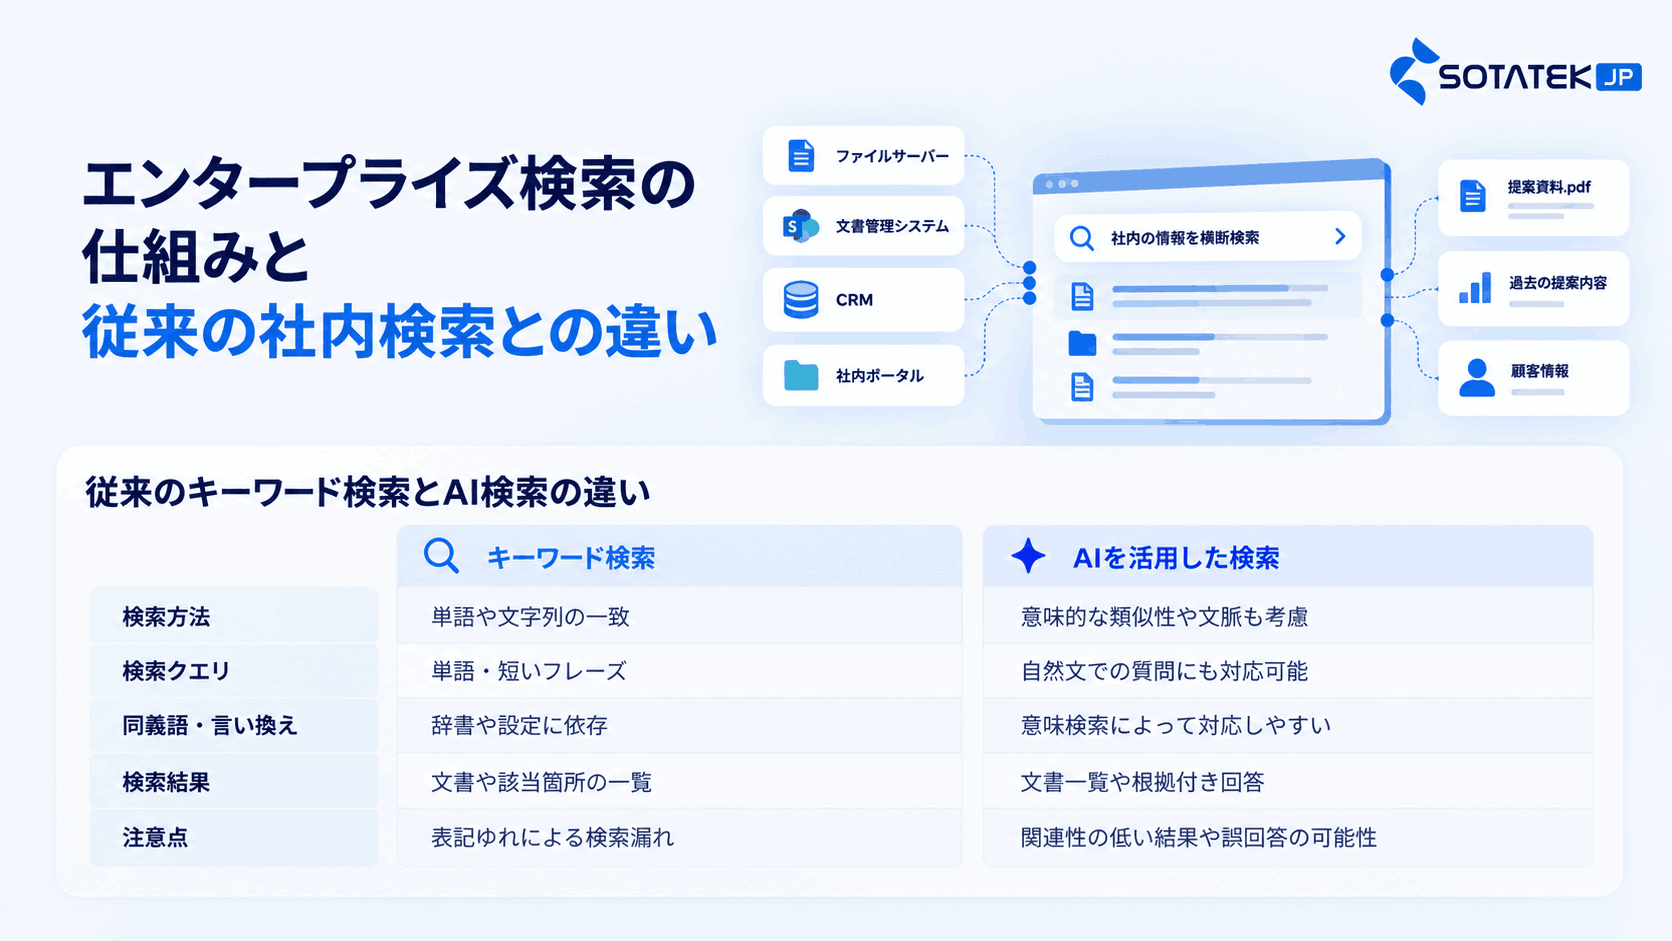
エンタープライズ 検索は、企業内に蓄積された文書や業務データを、複数のシステムにまたがって検索するための仕組みです。
検索対象には、ファイルサーバー、文書管理システム、社内ポータル、CRM、ナレッジベースなどが含まれます。
例えば、営業担当者が過去の提案内容を調べたい場合、通常は案件管理システムや共有フォルダなどを個別に確認する必要があります。
エンタープライズ 検索では、適切な連携とアクセス制御を設計することで、複数の情報源を横断して関連資料を探せるようになります。
従来のキーワード検索とAI検索の違い
従来の検索では、入力されたキーワードと文書内の文字列の一致を中心に結果を表示します。
一方、AIを活用した検索では、文章の意味や文脈を考慮して関連情報を探す方法も利用できます。
| 比較項目 | キーワード検索 | AIを活用した検索 |
|---|---|---|
| 主な検索方法 | 単語や文字列の一致 | 意味的な類似性や文脈も考慮 |
| 検索クエリ | 単語・短いフレーズ | 自然文での質問にも対応可能 |
| 同義語・言い換え | 辞書や設定に依存 | 意味検索によって対応しやすい |
| 検索結果 | 文書や該当箇所の一覧 | 文書一覧や根拠付き回答 |
| 注意点 | 表記ゆれによる検索漏れ | 関連性の低い結果や誤回答の可能性 |
ただし、AI検索が常にキーワード検索より優れているわけではありません。
製品番号、契約番号、顧客IDなど、文字列の一致が重要な検索では、キーワード検索が有効です。
そのため、企業向けの検索システムでは、キーワード検索と意味検索を組み合わせるハイブリッド検索が選択肢になります。
企業が社内情報を横断検索する際の主な課題
情報が複数のシステムに分散している
企業では、部門や業務によって利用するツールが異なります。
例えば、次のような状況です。
-
営業資料:Google Drive
-
社内規程:SharePoint
-
顧客情報:CRM
-
問い合わせ履歴:チケット管理システム
-
業務ノウハウ:社内Wiki
-
過去のやり取り:チャットツール
こうした情報を個別に検索していると、必要な資料を探すだけでも時間がかかります。
ファイル名やキーワードだけでは情報を見つけにくい
必要な情報が保存されていても、文書のタイトルや保存場所が分からなければ検索が難しくなります。
また、部署によって用語や略称が異なる場合、同じ内容でも検索結果に表示されないことがあります。
アクセス権限が複雑
社内のすべての情報を、すべての従業員が閲覧できるわけではありません。
人事情報、契約情報、経営資料、顧客データなどには、適切なアクセス制限が必要です。
複数のシステムを横断検索する場合も、元のシステムで設定された権限を尊重することが重要です。
情報が更新されても検索結果に反映されない
検索用のデータを定期的に取り込む構成では、元の文書が更新されても検索インデックスに反映されるまで時間がかかる場合があります。
古い情報が検索結果やAIの回答に利用されると、業務上の判断に影響する可能性があります。
AIを活用したエンタープライズ 検索の基本アーキテクチャ
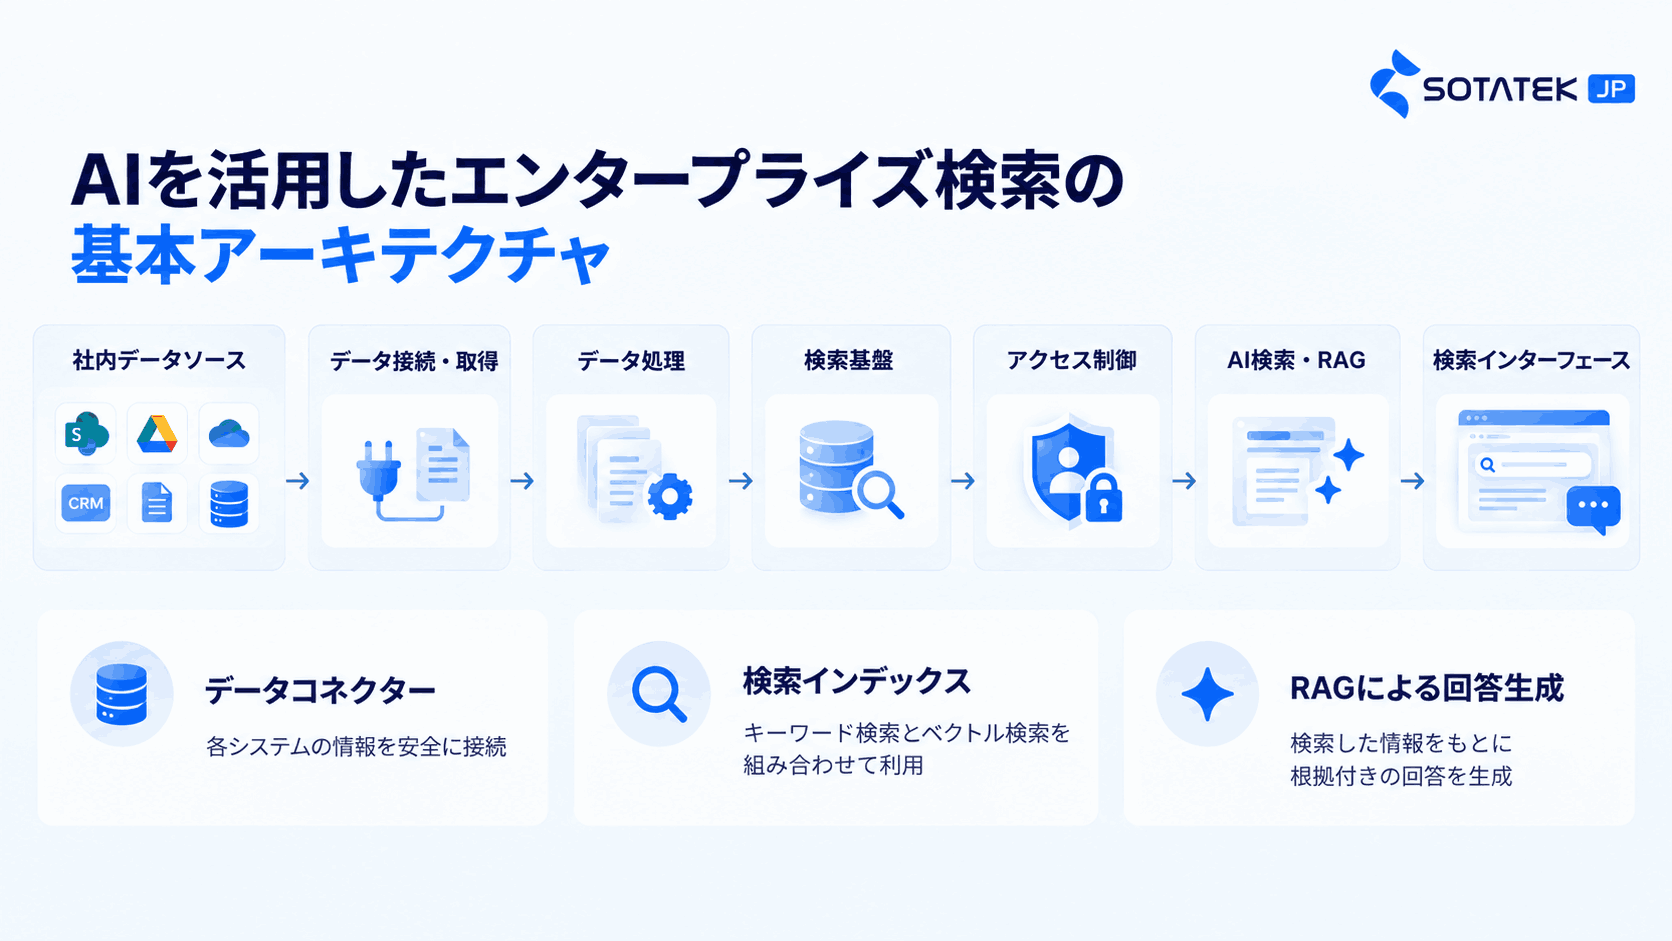
AIによる社内横断検索は、検索画面だけで構成されるものではありません。
複数のデータソースを安全に接続し、情報を検索可能な形に整え、ユーザーの権限に応じて結果を提供する仕組みが必要です。
基本的には、次のような構成が考えられます。
社内データソース
SharePoint/Google Drive/CRM/社内Wiki/ファイルサーバー
↓
データ接続・取得
コネクター/API/データ同期
↓
データ処理
文書解析/テキスト抽出/分割/メタデータ付与
↓
検索基盤
キーワード検索/ベクトル検索/ハイブリッド検索
↓
アクセス制御
ユーザー認証/権限チェック/監査ログ
↓
AI検索・RAG
関連情報の取得/回答生成/参照元の提示
↓
検索インターフェース
社内ポータル/チャットUI/業務アプリケーション
実際の構成では、認証・認可やログ管理は検索処理全体に適用する必要があります。上記は概念的な構成例です。
- データコネクターによる情報源との接続:データコネクターは、外部システムから情報を取得するための仕組みです。検索対象に応じて、標準コネクター、API、独自の連携処理などを利用します。ただし、接続できることと、必要な情報を適切な権限で検索できることは別の問題です。導入時には、取得できるデータの種類、更新頻度、認証方式、アクセス権限の扱いを確認する必要があります。
- 検索インデックスとベクトル検索:検索インデックスは、文書を効率的に検索するためのデータ構造です。AI検索では、文書や質問をベクトル表現に変換し、意味的に近い情報を探す方法も利用されます。ただし、ベクトル検索だけでは、製品コードや固有名詞などを正確に検索できない場合があります。そのため、キーワード検索とベクトル検索を組み合わせる方法が検討されます。
- RAGによる根拠付き回答:RAGは、検索によって取得した情報を参照しながら生成AIが回答を作成する仕組みです。例えば、従業員が「海外出張の精算ルールを教えてください」と質問した場合、関連する社内規程を検索し、その内容をもとに回答を生成する構成が考えられます。この際、回答だけでなく、参照した文書や該当箇所を提示できるようにすると、利用者が情報を確認しやすくなります。ただし、RAGを利用しても誤回答が完全になくなるわけではありません。
詳しくは「RAG(検索拡張生成)の仕組みとVectorDBの役割」をご覧ください。
社内横断検索における2つのデータ連携方式
複数のシステムを検索する際には、データを検索基盤へ取り込む方式と、検索時に元のシステムへ問い合わせる方式があります。
インデックス型|データを取り込んで検索
インデックス型では、外部システムから取得した情報を検索用の基盤に登録します。
検索時には、あらかじめ構築したインデックスを参照します。
メリット
-
複数の情報源をまとめて検索しやすい
-
検索処理を最適化しやすい
-
キーワード検索とベクトル検索を組み合わせやすい
注意点
-
データの同期処理が必要
-
更新や削除の反映に遅延が発生する可能性がある
-
インデックス側でも権限情報を適切に管理する必要がある
フェデレーテッド検索型|元のシステムへ問い合わせ
フェデレーテッド検索型では、検索時に接続先システムへ問い合わせて情報を取得します。
データを検索基盤へ複製せずに利用できる構成もあります。
メリット
-
最新情報を取得しやすい
-
機密データを外部インデックスへ複製しない構成を検討できる
-
元システムの検索機能やアクセス制御を活用できる場合がある
注意点
-
接続先のAPI性能や利用制限の影響を受ける
-
複数システムへの問い合わせで応答時間が長くなる可能性がある
-
情報源によって検索機能が異なる
どちらの方式を選ぶべきか
| 判断項目 | インデックス型 | フェデレーテッド検索型 |
|---|---|---|
| データの更新頻度 | 同期設計が必要 | 元システムの最新情報を取得しやすい |
| 検索性能 | 検索基盤側で最適化しやすい | 接続先システムに依存 |
| データの複製 | 原則として発生 | 複製を抑えられる構成も可能 |
| 権限管理 | 権限情報の同期・反映が重要 | 接続先での認可確認が重要 |
| システム依存 | インデックス基盤に依存 | 接続先APIの可用性に依存 |
実際には、文書の種類や機密性に応じて両方式を組み合わせる構成も考えられます。
RAGとGraph RAGはエンタープライズ 検索でどう使い分ける?
AI検索を高度化する技術として、RAGに加えてGraph RAGも注目されています。
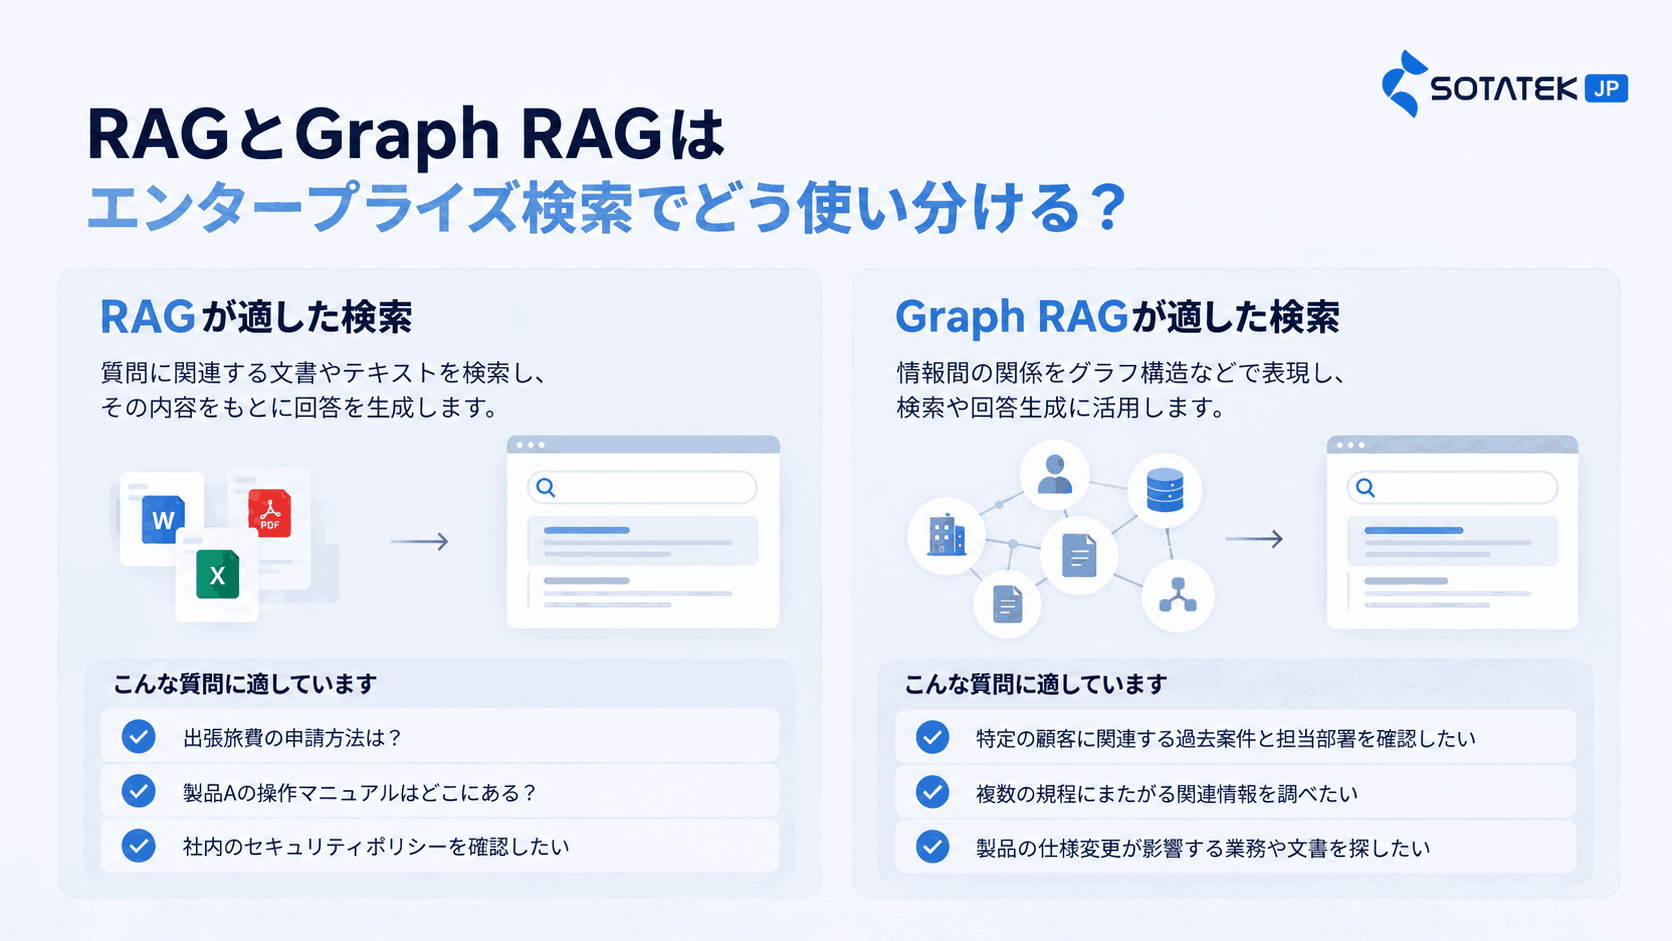
RAGが適した検索
一般的なRAGでは、質問に関連する文書やテキストを検索し、その内容をもとに回答を生成します。
例えば、次のような質問です。
-
出張旅費の申請方法は?
-
製品Aの操作マニュアルはどこにある?
-
社内のセキュリティポリシーを確認したい
関連する文書を取得できれば回答しやすい質問に適しています。
Graph RAGが適した検索
Graph RAGは、情報間の関係をグラフ構造などで表現し、検索や回答生成に活用するアプローチです。
例えば、次のような質問が考えられます。
-
特定の顧客に関連する過去案件と担当部署を確認したい
-
複数の規程にまたがる関連情報を調べたい
-
製品の仕様変更が影響する業務や文書を探したい
こうした質問では、単一の文書だけでなく、複数の情報の関係を把握することが重要になります。
ただし、Graph RAGがすべての検索で従来のRAGより優れているわけではありません。
知識グラフの構築・更新に追加のコストがかかるため、検索対象や質問の複雑さに応じた選択が必要です。
エンタープライズ 検索のセキュリティ対策
企業向けの検索システムでは、検索精度と同じくらいアクセス制御が重要です。
特に生成AIを組み合わせる場合、検索結果だけでなく、生成される回答にも機密情報が含まれる可能性があります。
- ユーザー権限に応じた検索結果の制御:例えば、人事部門だけが閲覧できる給与情報を、他部署の従業員が検索できてはいけません。検索インデックスに文書を登録する場合は、文書のアクセス権限を検索基盤へ適切に反映する必要があります。また、権限の変更や文書の削除が発生した際にも、検索結果へ速やかに反映する仕組みが重要です。
- AIへの情報提供前に権限を確認:RAGを利用する場合、生成AIに渡す検索結果は、ユーザーが閲覧を許可された情報に限定する必要があります。AIが回答を生成した後に機密情報を取り除くだけでは、十分な対策とはいえません。検索・取得段階で適切にアクセス制御することが重要です。
- ログ管理と監査:運用時には、検索クエリ、アクセスした文書、システムエラーなどを必要な範囲で記録することが考えられます。ただし、検索ログ自体にも機密情報や個人情報が含まれる場合があります。保存期間や閲覧権限を含めた管理が必要です。
- プロンプトインジェクションへの対策:外部文書や社内資料に、AIの動作を誘導する不正な指示が含まれている可能性があります。そのため、取得した文書を無条件に信頼せず、指示と参照データを分離する設計、権限制御、出力検証などを組み合わせる必要があります。
エンタープライズ検索の導入手順
ステップ1:検索対象と業務課題を明確
最初に、誰が、どのような情報を、何のために検索するのかを整理します。
例えば、営業部門であれば過去の提案資料、情報システム部門であれば障害対応履歴、人事部門であれば社内規程などが対象になります。
「社内のすべての情報を検索できるようにする」という広すぎる目標ではなく、特定の業務課題から始めることが重要です。
ステップ2:データソースと権限を調査
検索対象となるシステムを一覧化します。
あわせて、次の項目を確認します。
-
データの保存場所
-
ファイル形式
-
APIやコネクターの有無
-
更新頻度
-
アクセス権限
-
機密情報の有無
-
データの所有部門
ステップ3:検索方式とシステム構成を設計
対象データに応じて、インデックス型、フェデレーテッド検索型、または両者の組み合わせを検討します。
AIによる自然文検索が必要な場合は、RAGやハイブリッド検索などの採用も検討します。
ステップ4:限定的なPoCを実施
最初から全社導入するのではなく、特定部門や限定された文書群でPoCを実施します。
例えば、営業部門の提案資料やFAQなど、検索ニーズが明確な情報から始める方法があります。
ステップ5:検索品質と運用負荷を評価
PoCでは、回答の正確性だけでなく、必要な情報を見つけられるか、権限が適切に守られているか、更新情報が反映されるかを確認します。
ステップ6:対象部門を拡大し、継続改善
PoCの結果をもとに検索対象を広げます。
運用開始後も、検索ログや利用者からのフィードバックをもとに、検索精度やデータ品質を改善する必要があります。
エンタープライズ検索のPoCで確認すべきKPI
AI検索の評価では、単に「回答が自然かどうか」を確認するだけでは不十分です。
実際の業務で必要な情報を取得できるかを測定することが重要です。
| KPI | 評価内容 | 確認方法 |
|---|---|---|
| Recall@k | 必要な文書を上位k件に取得できるか | 正解文書セットとの比較 |
| Precision@k | 上位k件に関連文書がどれだけ含まれるか | 検索結果の関連性評価 |
| 回答の根拠整合性 | 回答が参照文書に裏付けられているか | 回答と出典の照合 |
| 検索成功率 | 利用者が必要な情報を見つけられた割合 | タスクベースの評価 |
| 検索所要時間 | 情報取得までに必要な時間 | 導入前後の比較 |
| 応答時間 | 検索・回答の処理時間 | システムログ |
| 権限違反件数 | 閲覧権限のない情報が露出しないか | 権限別テスト |
| 更新反映時間 | 元データの変更が検索に反映されるまでの時間 | 同期テスト |
特に、検索精度と回答品質は分けて評価することが重要です。関連文書を取得できていても、生成AIが誤った回答を作成する場合があります。
反対に、生成AIの文章が自然でも、必要な文書を取得できていない可能性があります。
PoCの評価シート例
| テスト項目 | 質問例 | 合格条件の例 |
|---|---|---|
| 正確な文書検索 | 最新の出張規程を探す | 現行版の規程が取得される |
| 複数文書検索 | 顧客Aの過去案件を調べる | 権限内の関連資料が取得される |
| 根拠付き回答 | 経費精算の条件を質問する | 回答と参照元が一致する |
| 権限管理 | 他部門の機密資料を検索する | 非許可情報が表示されない |
| 情報更新 | 規程を更新して再検索する | 設定した更新基準内で反映される |
合格基準は、業務の重要度や情報の機密性に応じて設定します。
エンタープライズ 検索の導入費用と運用コスト
エンタープライズ 検索の費用は、対象データの規模、接続するシステム数、AI機能、セキュリティ要件などによって異なります。そのため、すべての企業に共通する導入費用を示すことはできません。
主な費用項目は次のとおりです。
| 費用項目 | 主な内容 |
|---|---|
| 初期設計費 | 要件整理、検索方式、セキュリティ設計 |
| データ連携費 | API・コネクターの設定や開発 |
| 検索基盤費 | インデックス、データ保存、検索処理 |
| AI利用費 | Embedding、LLM、回答生成 |
| 運用費 | 監視、権限同期、データ更新、改善 |
| 評価費 | 検索品質のテスト、利用者評価 |
例えば、検索対象を1つの部門に限定する場合と、全社の複数システムを横断検索する場合では、必要な構成が大きく異なります。
また、AIによる回答生成を利用する場合は、検索基盤に加えてモデルの利用料金なども考慮する必要があります。
費用対効果を考える際のポイント
導入効果を評価する際は、検索時間の削減だけでなく、次のような観点も考慮できます。
-
社内問い合わせ対応の負担
-
重複した資料作成の削減
-
過去のナレッジの再利用
-
新入社員の情報収集支援
-
情報検索に伴う業務の中断
ただし、効果を定量化するには、導入前後で同じ条件の業務を比較する必要があります。
SotaAgentsによる企業内ナレッジの横断検索
AIを活用したエンタープライズ 検索を検討する際には、既存の文書や業務データをどのように検索し、実際の業務に活用するかが重要です。
SotaTekが提供するSotaAgentsは、企業向けのAIエージェントプラットフォームです。
SotaAgentsのReasoning & Knowledge Agentは、Graph RAGなどの技術を活用し、複数の情報源にまたがる知識の検索や、関連情報を踏まえた回答生成を支援します。
SotaAgentsの主な特徴
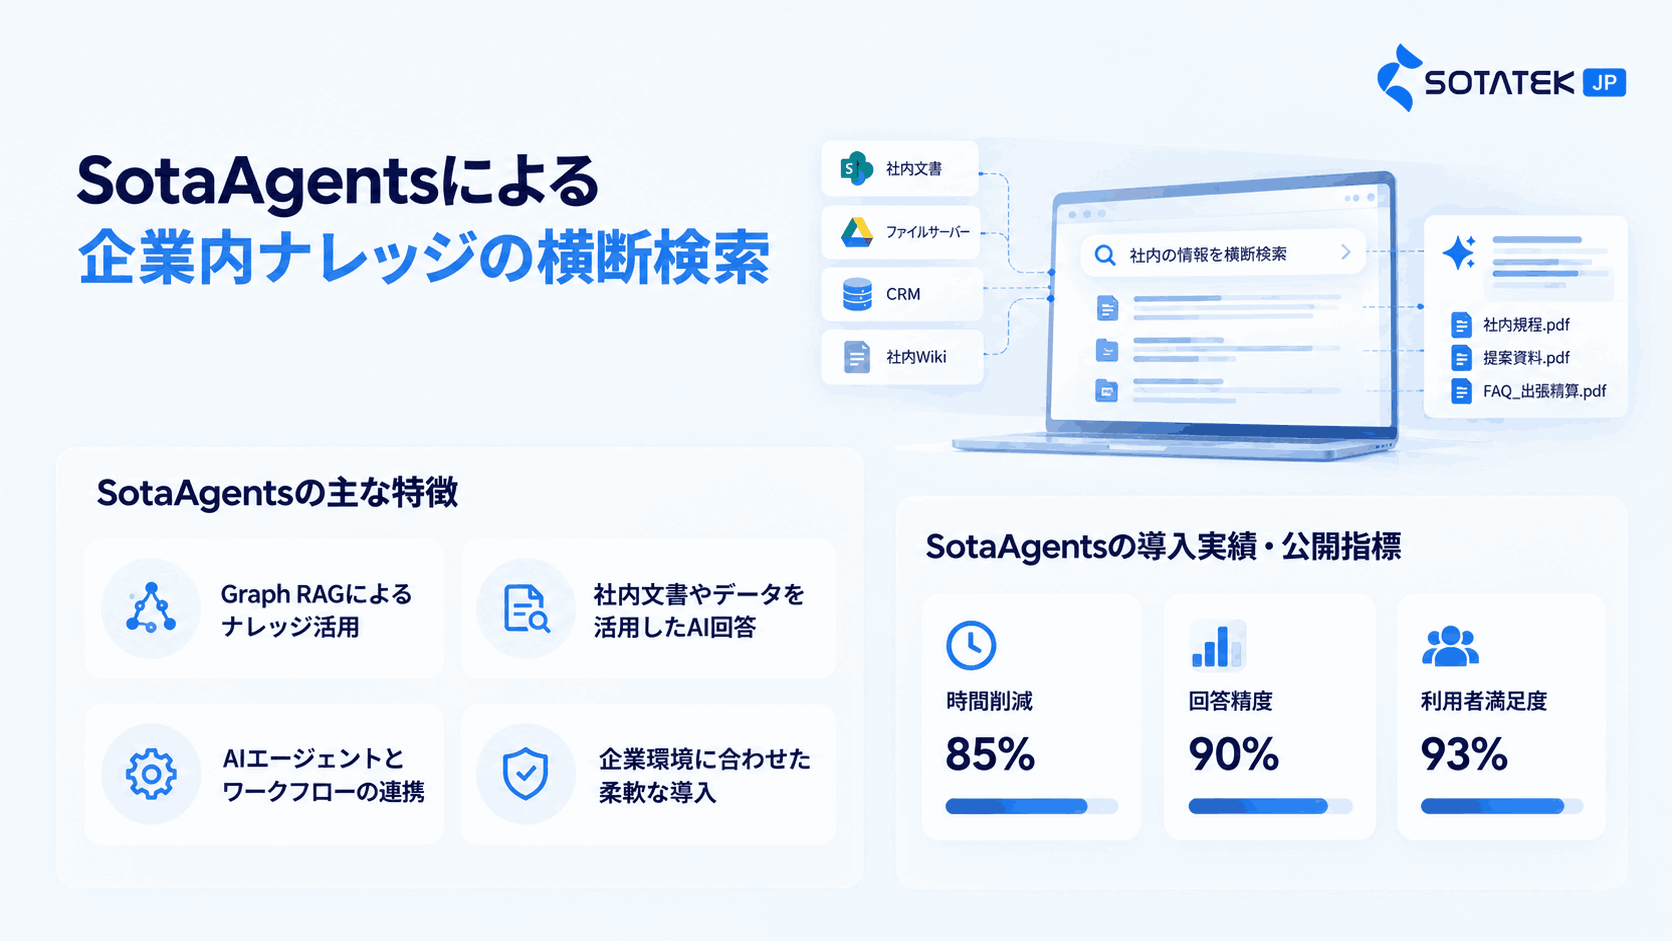
1. Graph RAGによるナレッジ活用
単一文書の検索だけでなく、情報間の関係を考慮した知識活用を支援します。
2. 社内文書やデータを活用したAI回答
企業が保有する文書や情報を参照し、業務に関連する質問への回答を支援します。
3. AIエージェントとワークフローの連携
情報検索だけでなく、業務システムとの連携や複数ステップの処理へ活用範囲を広げる構成も検討できます。
4. 企業環境に合わせた導入
データ管理や運用要件に応じた導入方式を検討できる点も、企業向けAI基盤を選ぶ際の重要な要素です。
なお、特定の外部システムとの接続可否、権限同期方式、導入構成については、個別の要件確認が必要です。
SotaAgentsの導入実績・公開指標
SotaTekの公式製品ページでは、SotaAgentsに関連する実績指標として、次の数値が紹介されています。
| 指標 | 公開値 |
|---|---|
| 時間削減 | 85% |
| 回答精度 | 90% |
| 利用者満足度 | 93% |
社内検索から業務自動化までを検討する企業へ
エンタープライズ 検索の導入では、検索精度だけでなく、データ接続、権限管理、運用、業務システムとの連携まで考慮する必要があります。
SotaAgentsは、こうした企業内ナレッジの活用やAIエージェントによる業務支援を検討する際の選択肢の一つです。
社内情報の横断検索やGraph RAGを活用したAIシステムの導入をご検討の方は、SotaAgentsの製品情報をご覧ください。
また、具体的な要件整理や開発については、SotaTek JapanのAI・機械学習サービスからご相談いただけます。
よくある質問(FAQ)
エンタープライズ 検索と社内検索の違いは何ですか?
社内検索は企業内の情報を探す仕組みの総称です。エンタープライズ 検索は、特に複数の業務システムや文書管理基盤にまたがる情報検索を対象とすることが多く、データ連携やアクセス制御が重要になります。
エンタープライズ 検索に生成AIは必要ですか?
必須ではありません。キーワード検索や検索インデックスだけでも構築できます。自然文による質問や根拠付き回答を実現したい場合は、RAGなどの生成AI技術を組み合わせる方法があります。
SharePointとGoogle Driveをまとめて検索できますか?
両方のデータソースに対応したコネクターやAPIを利用し、適切な認証・権限制御を設計すれば、横断検索を実現できる構成があります。ただし、具体的な対応範囲は採用する製品やシステムによって異なります。
RAGとGraph RAGはどちらを選ぶべきですか?
関連文書を検索して回答する用途では、一般的なRAGが適している場合があります。複数の情報の関係を扱う必要がある場合は、Graph RAGが選択肢になります。検索対象や質問の複雑さに応じて評価することが重要です。
AI検索で機密情報が漏れることはありませんか?
設計や運用が不適切な場合、機密情報が意図しない利用者に表示されるリスクがあります。ユーザー認証、文書単位の権限制御、検索時の認可確認、ログ管理などが必要です。
エンタープライズ 検索の導入にはどれくらいの期間がかかりますか?
対象システム数、データ量、権限設計、連携開発などによって異なります。最初は対象部門や文書を限定したPoCから始め、評価結果をもとに展開範囲を広げる方法が考えられます。
エンタープライズ 検索とAIエージェントは連携できますか?
はい。AIエージェントが必要な社内情報を検索し、その結果をもとに次の処理を実行する構成が考えられます。ただし、外部システムの操作には、検索とは別に適切な権限管理や承認フローが必要です。
まとめ
エンタープライズ 検索は、複数のシステムに分散した社内情報を横断的に検索し、必要な知識へアクセスしやすくする仕組みです。
AIを活用することで、キーワード検索だけでなく、意味検索やRAGによる自然文での質問にも対応できるようになります。
ただし、導入時には検索精度だけでなく、データ連携、アクセス権限、情報更新、セキュリティなどを含めた設計が重要です。
特に、複数の情報源を扱う企業では、インデックス型とフェデレーテッド検索型の使い分けや、RAG・Graph RAGの適用範囲を検討する必要があります。
まずは検索ニーズが明確な部門からPoCを実施し、検索成功率、回答品質、運用負荷などを評価することをおすすめします。
SotaAgentsを活用した社内ナレッジ検索やAIエージェントの導入については、SotaTek Japanへお気軽にご相談ください。