
生成AIやAIエージェントの企業活用が進むなか、新たに注目されているのが「ソブリンAI(Sovereign AI)」です。
企業がAIを業務に深く組み込むほど、社内文書、顧客情報、設計データ、業務ノウハウなど、重要なデータをAIが扱う機会も増えていきます。その際、「データはどこに保存されるのか」「誰がアクセスできるのか」「外部のAIモデルの学習に利用されないか」「特定のクラウドやAIベンダーに依存しすぎていないか」といった問題が重要になります。
ソブリン AIは、こうした課題に対して、AIに関わるデータ、モデル、インフラ、運用、ガバナンスに対する主導権を、自国・自社側で確保するという考え方です。
日本でもAIの開発基盤強化が進んでいます。経済産業省とNEDOが推進するGENIACでは、2026年6月にAIモデル開発を支援する第4期として16件のプロジェクトを採択しました。また政府は、AI・半導体分野に対して2030年度までの7年間で10兆円以上の公的支援を行う方針を示しています。
本記事では、ソブリンAIとは何か、国産AIやプライベートAIとの違い、その仕組み、日本で注目される背景、企業が導入する際のポイントまでわかりやすく解説します。
ソブリンAIとは?
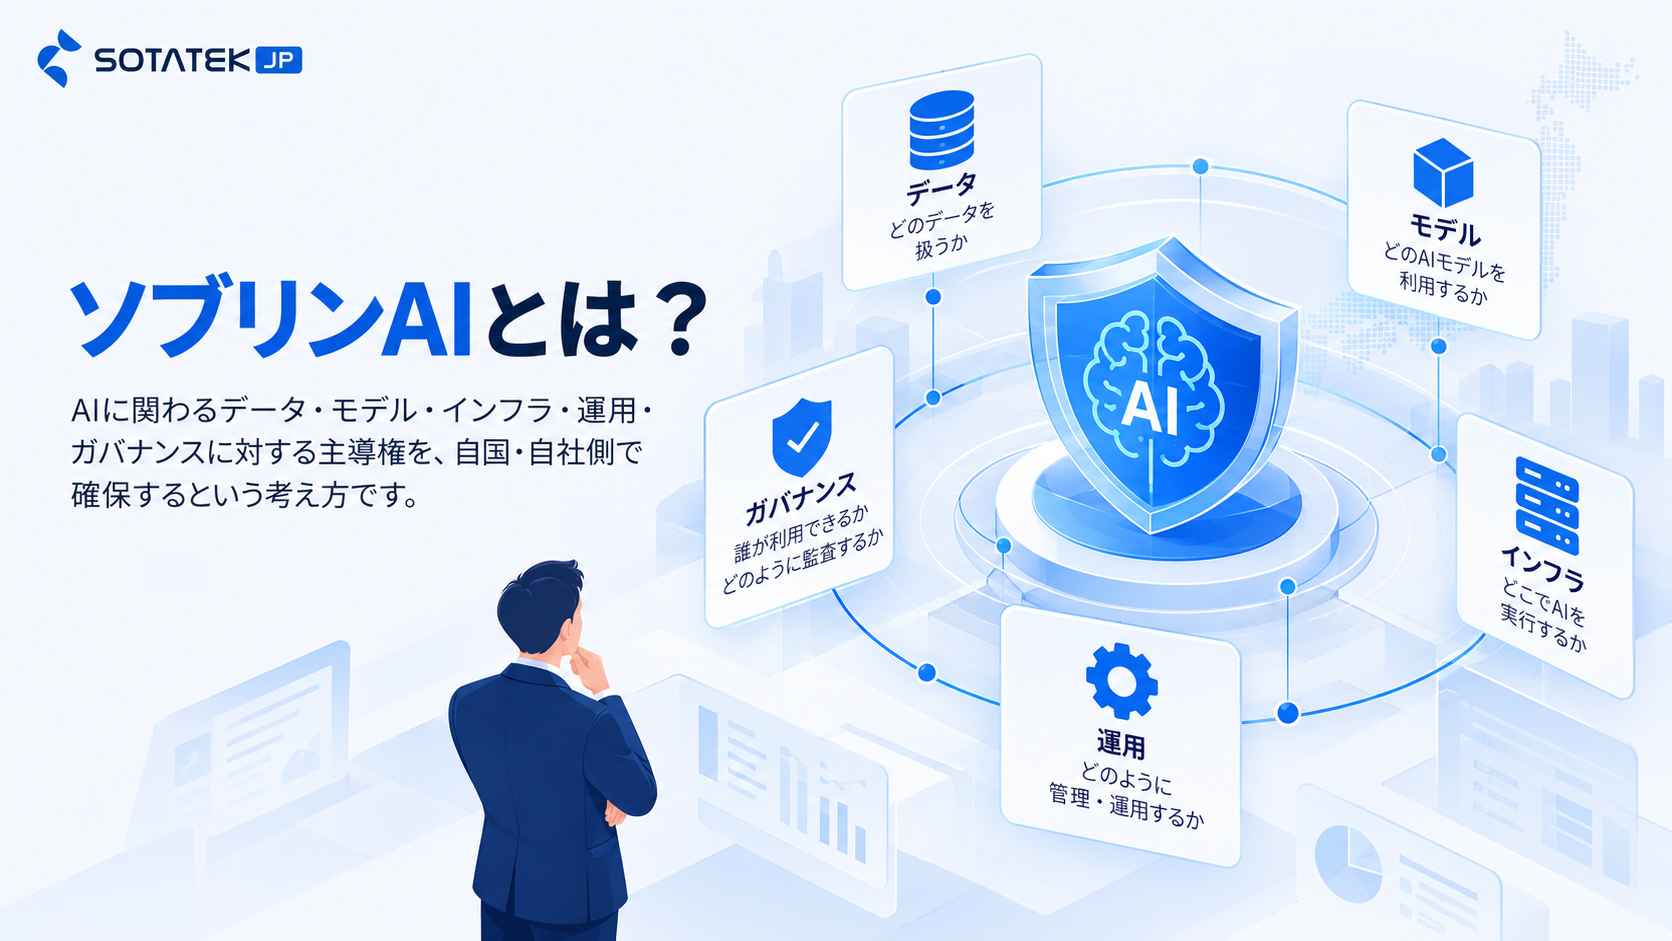
ソブリン AIとは、国家・地域・企業などが、AIを構成するデータ、モデル、インフラ、運用環境などを自らの方針に基づいて管理・統制できる状態を目指す考え方です。
「Sovereign」には「主権」という意味があります。
AIにおける主権というと国家レベルの話をイメージしやすいですが、現在では企業にとっても重要なテーマになっています。
例えば、企業が外部の生成AIサービスを利用する場合、サービスの構成によっては、データの保存場所、利用するモデル、アクセス管理、ログ管理、サービス仕様などを自社だけでは完全にコントロールできないことがあります。
一方、企業向けのソブリン AIでは、
- どのデータをAIへ渡すか
- データをどこに保存するか
- 誰がアクセスできるか
- どのAIモデルを利用するか
- どの環境でAIを実行するか
- AIの利用状況をどのように監査するか
といった要素を、自社の要件に合わせて設計・管理できる状態を目指します。
つまり、ソブリン AIを理解するときに重要なのは「どこの国で開発されたAIか」だけではありません。「AIシステムの何を、誰が、どこまでコントロールできるのか」という視点が重要です。
なぜ今、ソブリン AIが注目されているのか
ソブリン AIが注目される背景には、生成AIが実験段階から実際の業務システムへ入り始めたことがあります。
AIが扱うデータの重要性が高まっている
一般的な質問に回答するAIと、社内システムに接続されたAIでは、扱う情報の性質が大きく異なります。
企業向けAIでは、契約書、顧客情報、研究開発データ、設計情報、社内規定、財務情報など、外部へ容易に公開できないデータを扱う場合があります。
そのため、AIの性能だけではなく、データをどこで、どのように管理するかが重要になります。
AIエージェントの普及
AIエージェントは質問へ回答するだけではなく、社内データを参照したり、外部ツールや業務システムと連携したりしながらタスクを実行します。
AIが企業システムの奥深くまで接続されるほど、アクセス権限やデータガバナンスの重要性も高まります。
>>>関連記事:【完全版】AIエージェントとは?仕組み、種類、AIチャットボットとの違い
特定ベンダーへの依存
企業AIを特定のモデル、クラウド、プラットフォームだけに強く依存させると、料金体系、サービス仕様、提供条件などの変更がシステム全体へ影響する可能性があります。
そのため、「最も性能の高いモデルは何か」だけでなく、将来的にモデルやインフラを変更できる設計になっているかという視点も重要です。
ソブリン AIと国産AI・プライベートAI・ソブリンクラウドの違い
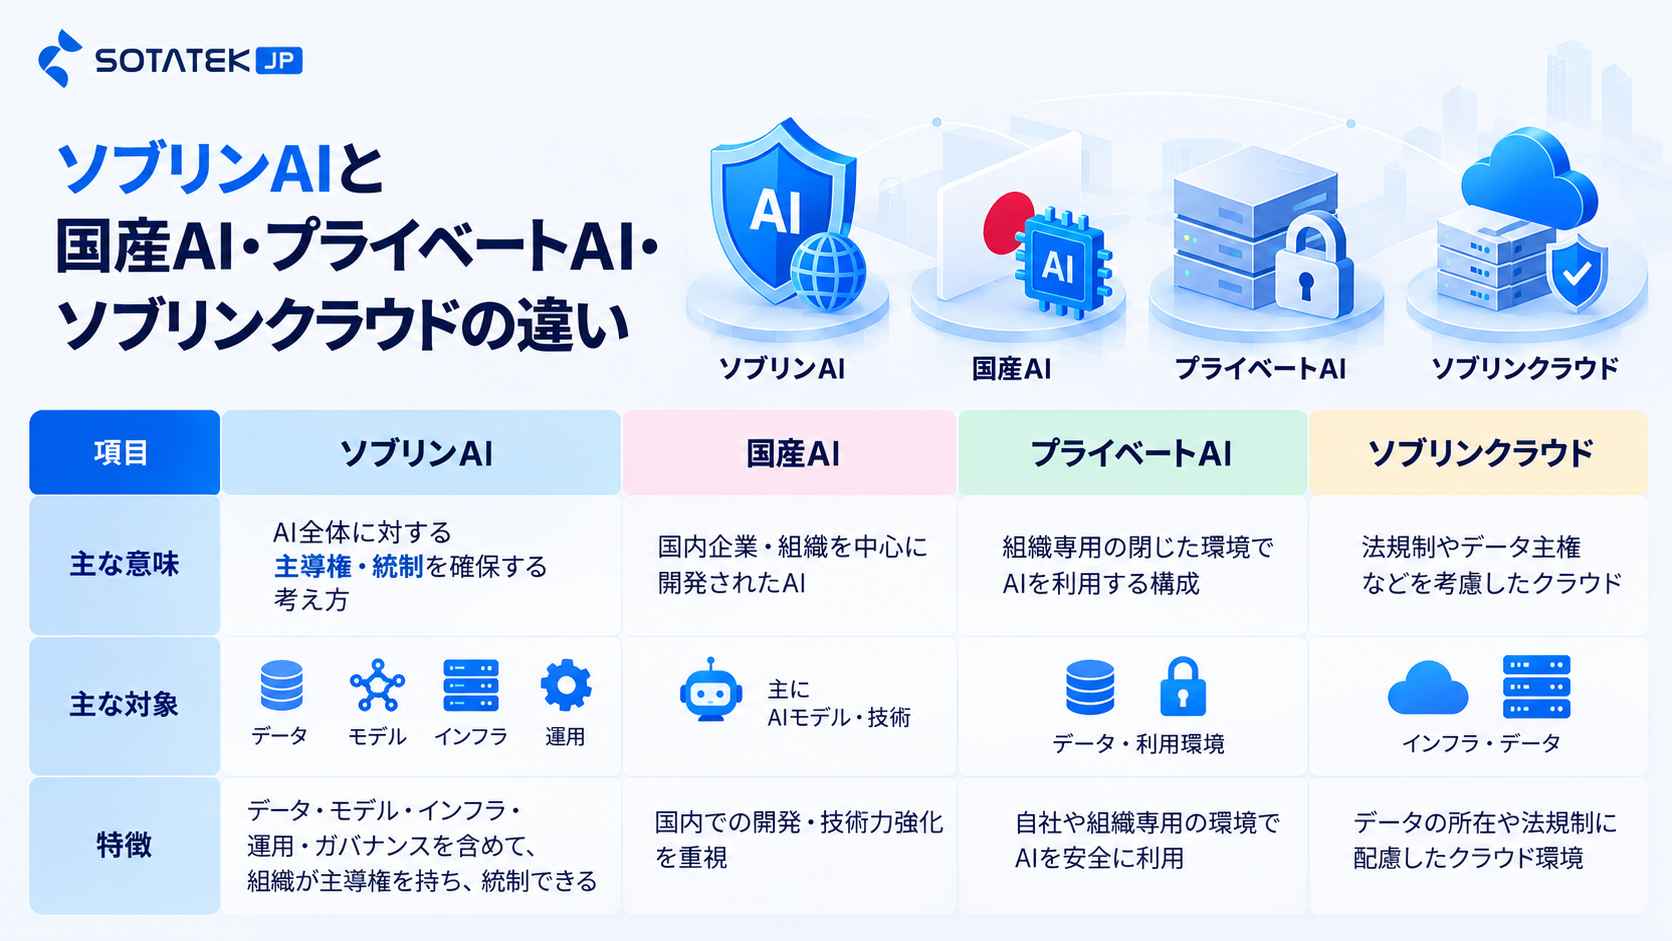
ソブリン AIと混同されやすい言葉として、国産AI、プライベートAI、ソブリンクラウドがあります。
| 主な意味 | 主な対象 | |
|---|---|---|
| ソブリン AI | AI全体に対する主導権・統制を確保する考え方 | データ・モデル・インフラ・運用など |
| 国産AI | 国内企業・組織を中心に開発されたAI | 主にAIモデル・技術 |
| プライベートAI | 組織専用の閉じた環境でAIを利用する構成 | データ・利用環境 |
| ソブリンクラウド | 法規制やデータ主権などを考慮したクラウド | インフラ・データ |
| オンプレミスAI | 自社設備内でAIを構築・運用する方式 | 実行環境 |
特に重要なのは、ソブリン AI = オンプレミスAIではないという点です。
自社サーバーでAIを動かしていても、特定モデルへの依存度が高く、モデルやデータの管理方法を十分に統制できなければ、AI全体の主権を確保できているとは限りません。
逆にクラウドを利用していても、データ保存場所、アクセス権限、暗号化、モデル選択、ログ、運用ポリシーなどを適切に管理することで、組織が求める主権レベルを実現できる場合があります。
ソブリン AIは特定の製品やデプロイ方式ではなく、AIシステムをどのように統制するかという設計思想として捉えることが重要です。
ソブリンAIを構成する5つの「主権」
企業におけるソブリンAIは、一つの要素だけでは成立しません。
次の5つに分けると理解しやすくなります。
データの主権
↓
モデルの主権
↓
インフラの主権
↓
運用の主権
↓
ガバナンスの主権
データの主権
自社データをどこに保存し、誰が利用できるのかを管理できる状態です。
特に機密情報を扱う場合は、保存場所だけではなく、AIモデルへの入力データ、ログ、生成結果などのライフサイクル全体を確認する必要があります。
モデルの主権
どのAIモデルを利用するかを企業側で選択・変更できる状態です。
一つのLLMだけに依存するのではなく、用途やセキュリティ要件に応じて複数のモデルを使い分けられる設計も選択肢になります。
インフラの主権
AIを実行する環境をコントロールできることです。
パブリッククラウド、プライベートクラウド、ハイブリッド、オンプレミスなどから、要件に応じた環境を選択します。
運用の主権
AIの設定変更、アップデート、障害対応、監視などを、自社の運用方針に基づいて管理できる状態です。
ガバナンスの主権
誰がどのAIやデータへアクセスできるのかを管理し、利用履歴を確認・監査できる状態です。
企業利用ではRBAC(Role-Based Access Control)、監査ログ、利用ポリシーなどが重要になります。
ソブリンAIの仕組み
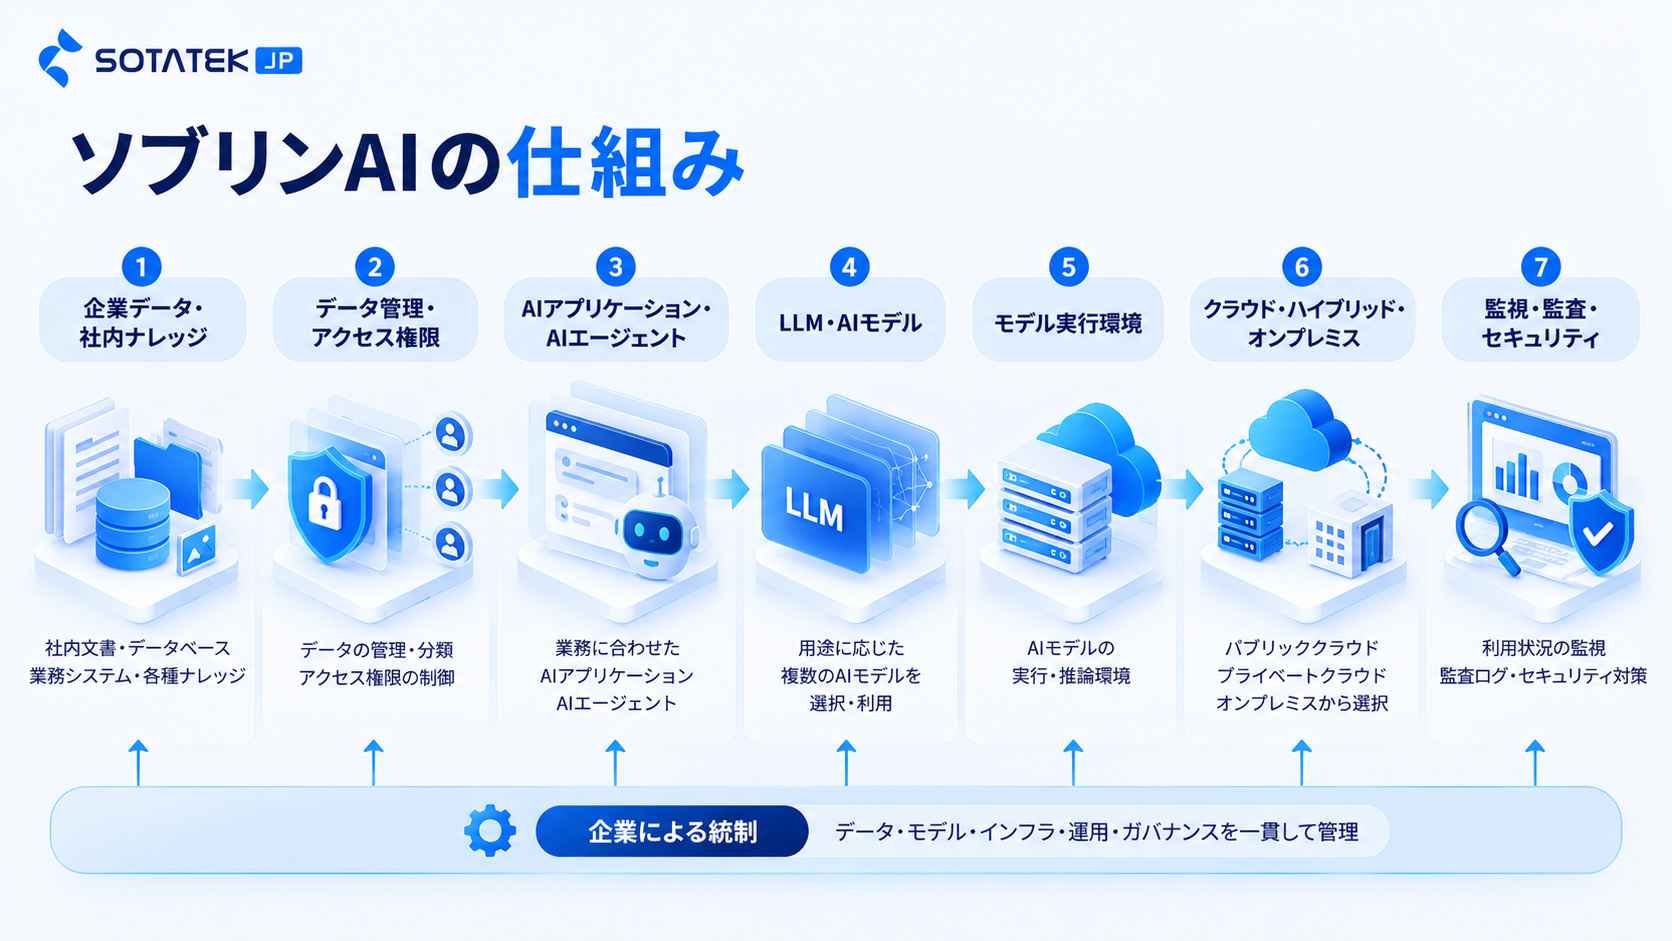
企業向けソブリン AIは、一つのAIモデルを導入するだけでは実現できません。
基本的には次のような複数のレイヤーから構成されます。
企業データ・社内ナレッジ
↓
データ管理・アクセス権限
↓
AIアプリケーション・AIエージェント
↓
LLM・AIモデル
↓
モデル実行環境
↓
クラウド・ハイブリッド・オンプレミス
↓
監視・監査・セキュリティ
↓
企業による統制
例えば、社内ナレッジ検索AIを構築する場合、単純にLLMへ社内文書を送信するのではなく、RAG(検索拡張生成)を利用して必要な情報だけを取得し、ユーザーの権限に応じて参照可能な情報を制御する方法があります。
RAGの仕組みやVectorDBの役割については、こちらの記事でも詳しく解説しています。
重要なのはモデル単体ではなく、データ → AI → インフラ → セキュリティ → 運用まで含めて統制できるアーキテクチャを設計することです。
日本でソブリンAIの取り組みが進む背景
日本でも、国内のAI開発力やAIインフラを強化する動きが進んでいます。
代表的な取り組みが、経済産業省とNEDOによるGENIAC(Generative AI Accelerator Challenge)です。
GENIACでは、国内の生成AI開発力を強化するため、基盤モデル開発に必要な計算資源の確保やデータ活用実証などを支援しています。
2026年6月には、AIモデル開発に必要な計算資源を支援するGENIAC第4期として16件のプロジェクトが採択されました。
さらに経済産業省は「AI・半導体産業基盤強化フレーム」において、AI・半導体分野に対して2030年度までの7年間で10兆円以上の公的支援を行い、10年間で50兆円を超える官民投資を促す方針を示しています。
こうした政策を「ソブリン AI政策」と単純に言い換えることはできません。
一方で、AIモデルだけではなく、計算資源、データ、AI開発能力を国内に形成する取り組みは、日本がAIに対する技術的な選択肢と自律性を確保するうえで重要な基盤となります。
企業がソブリン AIを導入するメリット
- 機密データをコントロールしやすい:企業がAIを本格活用するほど、社内データとの接続は避けて通れません。ソブリン AIの考え方を取り入れることで、どのデータをどの環境で利用するか、誰がアクセスできるかなどを自社のセキュリティポリシーに合わせて設計しやすくなります。
- AIガバナンスを強化できる:アクセス権限、利用ログ、モデル、データなどを一元的に管理できれば、「誰が・何の目的で・どのAIを利用したか」を把握しやすくなります。
- ベンダーロックインを抑えやすい:AI技術は非常に速いスピードで変化しています。モデルを切り替えられるアーキテクチャにしておくことで、特定のAIプロバイダーへ過度に依存するリスクを抑えられます。
- 自社固有のナレッジを活用できる:企業が持つ大きな資産の一つが、社内に蓄積されたデータや業務ノウハウです。これらを外部へ公開するのではなく、適切に管理された環境の中でRAGやAIエージェントと接続することで、自社固有のAI活用につなげられます。
ソブリン AIが特に重要になる企業・業務
すべての企業が完全なソブリン AI環境を構築する必要があるわけではありません。
重要性が高くなるのは、例えば次のようなケースです。
- 金融・保険:顧客情報、取引情報、内部文書など、高い機密性が求められるデータを扱います。
- 医療・ヘルスケア:患者情報や医療データなど、取り扱いに慎重さが求められる情報があります。
- 製造業:設計図、製造条件、品質データ、熟練者のノウハウなど、企業競争力そのものにつながる情報をAIで利用する可能性があります。
- 行政・公共:住民情報などを扱う場合、データ管理や説明責任が特に重要になります。
- 研究開発:未公開の技術情報や知的財産をAIへ接続する場合、外部サービスへの情報送信を慎重に設計する必要があります。
つまり、AIが扱うデータの機密性 × AIが業務へ与える影響が高くなるほど、ソブリン AIの考え方も重要になります。
ソブリン AI導入の課題
ソブリン AIにはメリットがある一方、「すべて自社で管理すればよい」という単純な話ではありません。
- コスト:自社専用のAIインフラやGPU環境を構築する場合、初期投資だけでなく、保守、電力、監視、人材など継続的なコストが発生します。そのため、主権を高めることで得られるメリットとコストのバランスを考える必要があります。
- AI人材・運用体制:オンプレミスやプライベート環境でAIを運用する場合、モデル、インフラ、セキュリティ、MLOps・LLMOpsなど複数領域の知識が必要になります。
- モデル性能とのバランス:セキュリティを重視して閉じた環境を構築しても、業務に必要なモデル性能を確保できなければ意味がありません。主権・セキュリティ・性能・コストのバランスを考えることが重要です。
- 技術の変化:AIモデルやプラットフォームは短期間で変化します。現在最適な構成が数年後も最適とは限らないため、特定技術へ過度に依存しないアーキテクチャも必要になります。
企業に必要な「主権レベル」はどう決める?
ソブリン AIは「導入する・しない」の二択で考えるより、どの程度の主権が必要なのかを決める方が現実的です。
例えば、次のように整理できます。
AIで扱うデータの機密性は高いか?
↓
データを外部環境へ送信できるか?
↓
保存場所を指定する必要があるか?
↓
AIモデルを自社で選択・変更する必要があるか?
↓
特定ベンダーへの依存をどこまで許容できるか?
↓
アクセス管理・監査要件はどの程度必要か?
↓
必要な主権レベルを決定
例えば一般公開情報を使った文章作成であれば、パブリックな生成AIサービスでも十分な場合があります。
一方、研究データや機密情報を利用する社内AIエージェントでは、Private Cloud、Hybrid、On-premiseなどを含め、より高い統制レベルが必要になる可能性があります。
すべてを閉じることではなく、リスクに応じて適切な主権レベルを設計することが重要です。
ソブリン AI導入の進め方
企業がソブリン AIを検討する場合、いきなり自社AI基盤を構築するのではなく、次の順序で整理すると進めやすくなります。
1|AIを利用する業務を特定する
↓
2|利用するデータを分類する
↓
3|セキュリティ・法規制・ガバナンス要件を整理する
↓
4|必要な主権レベルを決める
↓
5|AIモデル・RAG・AIエージェントなどの構成を設計する
↓
6|クラウド・ハイブリッド・オンプレミスから実行環境を選ぶ
↓
7|限定された業務でPoCを実施する
↓
8|監視・監査・アクセス管理を含めて本番運用する
ここでも重要なのは、「どのLLMを使うか」から始めないことです。
まず業務とデータの性質を確認し、そのリスクに応じてAIアーキテクチャを決める必要があります。
SotaTek Japanが考える企業向けソブリン AI
企業にとってのソブリン AIは、単に「データを社外に出さないこと」ではありません。
AIが業務の一部として利用されるようになるほど、
社内データ
↓
企業ナレッジ
↓
アクセス権限
↓
AIアプリケーション・AIエージェント
↓
AIモデル
↓
実行環境
↓
監視・ガバナンス
というシステム全体をどこまで企業自身がコントロールできるかが重要になります。
SotaTek Japanでは、AI・機械学習を中心に、企業の業務環境やセキュリティ要件に応じたAIシステムの設計・開発を支援しています。
また、企業向けAIエージェントプラットフォーム「SotaAgents」では、単一のAIモデルへ固定するのではなく、企業の用途に合わせたモデルやAIエージェントを業務システム・企業ナレッジと接続するアプローチを採用しています。
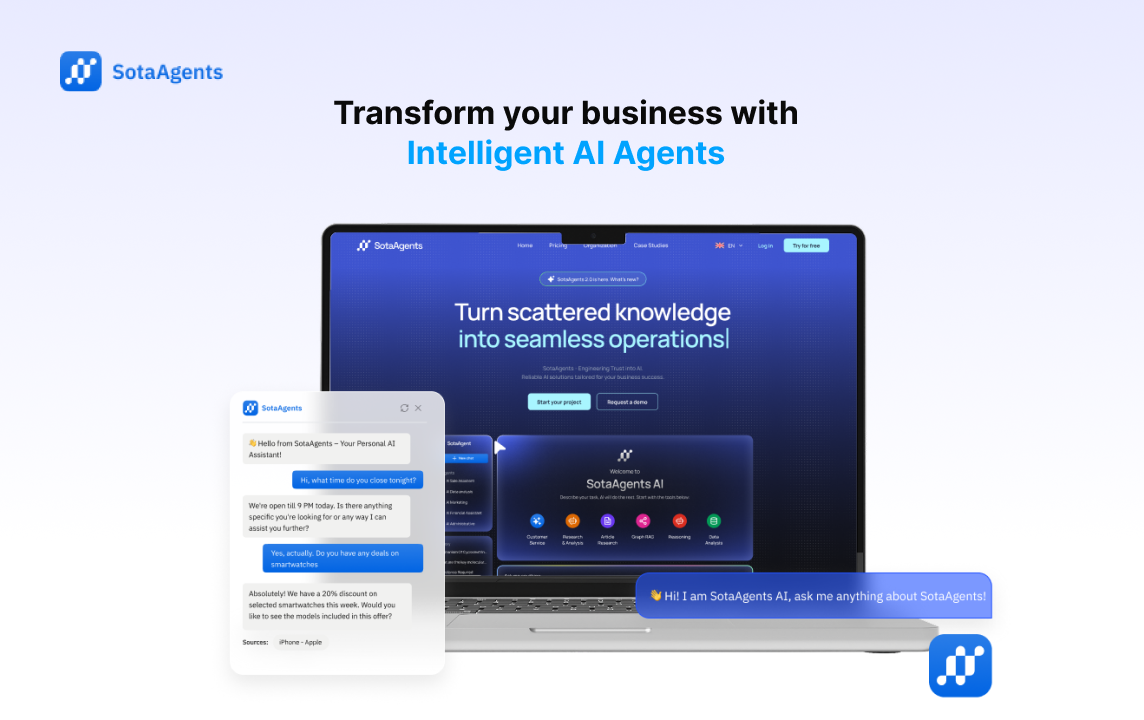
デプロイメントについても、クラウドだけでなく、ハイブリッドやオンプレミスを含め、企業のデータガバナンスやセキュリティ要件に応じた構成を検討できます。SotaTek JapanのAIエージェントプラットフォーム比較でも、デプロイ方式やガバナンスを含めた選定ポイントを紹介しています。
ソブリン AIで重要なのは、すべてを自社で開発・保有することではありません。自社にとって重要なデータ・モデル・インフラ・運用に対する「選択権」と「統制権」を失わないこと
が、企業向けソブリン AIを考えるうえで重要なポイントです。
よくある質問(FAQ)
ソブリン AIとは何ですか?
ソブリン AIとは、国・地域・企業などが、AIに関わるデータ、モデル、インフラ、運用、ガバナンスなどを自らの方針に基づいて管理・統制できる状態を目指す考え方です。
ソブリン AIと国産AIの違いは?
国産AIは主に国内で開発されたAIモデルや技術を指します。一方、ソブリン AIはモデルの開発国だけではなく、データ、インフラ、アクセス権限、運用などAIシステム全体に対する主導権を重視します。
ソブリン AIはオンプレミスでなければ実現できませんか?
必ずしもオンプレミスである必要はありません。企業の要件によっては、プライベートクラウドやハイブリッド構成でも必要な主権レベルを確保できます。重要なのは、データやモデル、アクセス権限、運用環境などを必要な範囲で統制できることです。
ソブリン AIとプライベートAIの違いは?
プライベートAIは主に組織専用の閉じた環境でAIを利用することに重点があります。ソブリン AIはそれに加えて、モデル選択、インフラ、データ、ガバナンス、ベンダー依存などを含めた、より広い「AIに対する主導権」を扱います。
すべての企業にソブリン AIが必要ですか?
必ずしも必要ではありません。公開情報のみを扱う一般的なAI利用では、パブリックなAIサービスが合理的な場合もあります。機密性の高いデータを扱う場合や、AIが重要業務へ深く組み込まれる場合ほど、ソブリン AIの考え方が重要になります。
まとめ
ソブリン AIは、「海外AIを使わない」「すべてをオンプレミスで構築する」といった単純な概念ではありません。
重要なのは、企業がAIに関わるデータ、モデル、インフラ、運用、ガバナンスに対して、必要な主導権を持ち続けられるかという点です。
AIが文章生成ツールからAIエージェント、業務システムへと広がるにつれて、AIが企業の重要なデータや意思決定プロセスへアクセスする機会も増えていきます。
そのため今後は「どのAIモデルが高性能か」だけではなく、「データはどこにあるのか」「誰がアクセスできるのか」「モデルを変更できるのか」「特定のサービスが利用できなくなっても継続できるのか」といった視点が、企業のAI戦略において重要になるでしょう。
ソブリン AI導入では、すべてを自社で管理することを目的にするのではなく、業務とデータのリスクに応じて、自社に必要な主権レベルを設計することが第一歩となります。