logo

자율주행, 안면 인식, 의료 영상 분석을 위한 객체 탐지(Object Detection), 이미지 세그멘테이션(Image Segmentation), 바운딩 박스(Bounding Boxes), 폴리곤(Polygons), 랜드마크(Landmarks), 시맨틱 세그멘테이션(Semantic Segmentation) 서비스를 제공합니다.

챗봇과 텍스트 기반 AI 모델 고도화를 위한 개체명 인식, 감성 분석, 의도 분류, 문맥 인지 어노테이션 등 고품질 자연어 처리(NLP) 데이터 라벨링 서비스를 제공합니다.

음성 비서와 음성 분석 AI 모델 고도화를 위한 전사, 타임스탬핑, 화자 구분 등 고정밀 오디오 데이터 라벨링 서비스를 제공하며, 다국어 및 다양한 억양을 폭넓게 지원합니다.

컴퓨터 비전을 위한 데이터 라벨링

객체 탐지부터 이미지 세그멘테이션까지, 차세대 AI 기반 시각 지능 구현을 위해 정밀한 시각 데이터셋을 어노테이션합니다.
SotaTek의 컴퓨터 비전 데이터 라벨링 서비스는 자율주행차, 안면 인식 시스템, 의료 영상 진단 등 정확한 시각 정보 해석이 요구되는 다양한 산업 분야에 필수적인 AI 모델 학습 기반을 제공합니다.

바운딩 박스 및
폴리곤 어노테이션
랜드마크 식별 및 추적
시맨틱 및
인스턴스 세그멘테이션
다양한 이미지 포맷에서의
높은 정확도
다양한 조명 및 환경 조건 지원

데이터 라벨링이 필요한 이유

데이터 라벨링의 핵심 효과

정밀한 예측 성능

데이터 활용성 향상

유연한 확장성

비용 최적화

핵심 산업 분야

SotaTek이 지원하는 산업

01

자율주행차

객체 탐지, 차선 추적, 보행자 인식을 위한 인지(Perception) 모델을 학습시켜 자율주행 기술의 고도화를 지원합니다.

02

헬스케어

의료 영상 및 환자 데이터를 정밀하게 어노테이션하여 진단 및 예측 모델 구축을 지원하고, 생명을 구하는 AI 기술 발전에 기여합니다.

03

리테일 & 이커머스

정밀하게 라벨링된 상품 데이터를 기반으로 개인화 추천 시스템과 스마트 비주얼 검색 기능을 구현합니다.

04

보안 및 영상 감시

안면 인식 및 위협 탐지 시스템의 정확도를 향상시켜 보다 안전한 환경 구축을 지원합니다.

05

농업

위성 및 드론 이미지를 정밀하게 라벨링하여 작물 생육 모니터링과 수확량 예측 최적화를 지원합니다.

06

로보틱스

비전 및 센서 데이터 라벨링을 통해 로봇이 환경, 제스처, 객체를 정확히 인식하도록 학습을 지원합니다.

07

금융 & 뱅킹

문서, 거래 내역, 커뮤니케이션 데이터를 정밀하게 태깅하여 사기 탐지와 프로세스 자동화를 지원하고, 자산 보호와 운영 효율화를 실현합니다.

08

보험

보험 청구 문서, 현장 점검 이미지, 보험 계약 데이터를 정밀하게 라벨링하여 언더라이팅 프로세스를 효율화하고 리스크 평가 정확도를 향상시킵니다.

09

제조 & 물류

라벨링된 운영 데이터를 기반으로 자동화 및 예지 정비를 고도화하여 다운타임을 최소화하고 공급망을 최적화합니다.

10

야생동물 보전

이미지 및 영상 데이터셋을 정밀하게 라벨링하여 종 식별과 동물 행동 모니터링을 지원하고, 보전 활동과 생태 연구에 기여합니다.

고품질 데이터 라벨링으로 AI 모델의 성능을 극대화하세요.

지금 상담하기!

프로젝트 문의하기

SotaTek의 강점

왜 SotaTek 데이터 라벨링 서비스인가?

+99%

어노테이션 정확도

24/7

상시 지원 체계

100%

데이터 보안 보장

SotaTek의 경쟁 우위

01

고품질 & 높은 신뢰성

다단계 품질 관리 프로세스와 전문 인력의 검수를 통해 99% 이상의 어노테이션 정확도를 보장합니다.

02

빠른 프로젝트 수행

애자일(Agile) 기반 워크플로우로 촉박한 일정에도 품질과 정확도를 유지하며 신속하게 대응합니다.

03

비용 효율적 가격 정책

예산과 프로젝트 범위에 맞춘 유연한 협업 모델로 최적의 비용 구조를 제공합니다.

04

철저한 데이터 보안

ISO 27001, GDPR, HIPAA 등 국제 보안 규정을 준수하여 데이터 기밀성을 완벽하게 보호합니다.

05

확장 가능한 운영 역량

파일럿 프로젝트부터 엔터프라이즈 규모까지 일관된 품질로 안정적인 확장이 가능합니다.

06

글로벌 고객 신뢰

미국, 영국, 유럽, APAC 등 글로벌 시장에서 다양한 고객과 협업하며 검증된 역량을 보유하고 있습니다.

품질 중심 접근 방식

고객의 구체적인 유즈케이스와 어노테이션 가이드라인을 깊이 있게 이해하고 프로젝트 범위를 명확히 정의합니다.
도메인 특화 정확도를 확보하기 위해 전문 어노테이터를 대상으로 맞춤형 교육을 진행합니다.
고도화된 툴과 체계적인 방법론을 기반으로 다층 구조의 정밀 데이터 라벨링을 수행합니다.
엄격한 다단계 QA 검수와 검증 프로토콜을 통해 일관된 고품질 결과를 보장합니다.

원활한 결과물 전달과 함께 지속적인 지원 및 반복 개선을 통해 장기적인 AI 성능 향상을 지원합니다.

프로젝트 문의하기 icon play
our quality

SotaTek과 함께하세요

“

비즈니스 요구에 최적화된 신뢰할 수 있는 도메인 특화 데이터 라벨링 서비스를 제공합니다. 숙련된 어노테이터와 전문 QA 팀이 함께하여 비용 효율성을 유지하면서도 높은 정확도의 AI 학습 데이터를 제공합니다.

파일럿 프로젝트부터 전사적 AI 확장까지, SotaTek은 정밀성, 확장성, 그리고 강력한 보안 체계를 기반으로 성공적인 AI 구축을 지원합니다.
전 세계 유수 기업들이 핵심 AI 학습 데이터를 SotaTek에 맡기고 있습니다.

소타텍 포트폴리오

portfolio1

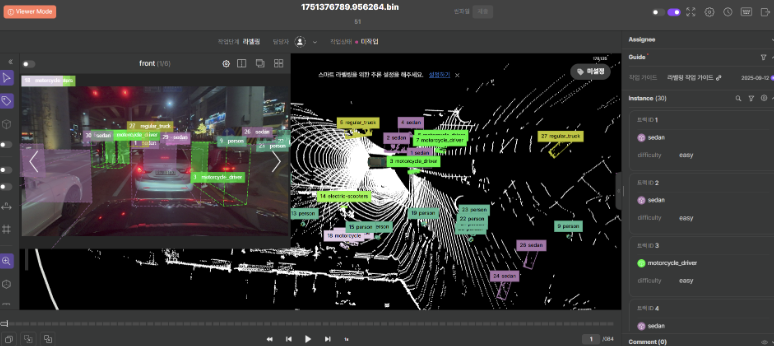
3D Cloud Point Labelling

SotaTek은 데이터 어노테이션 및 검증을 수행하는 전문 QC 팀과 라벨러를 보유하고 있으며, 다음과 같은 데이터 검수를 제공합니다:

  • 3D LiDAR 데이터 검수
  • 교통 신호등 데이터 검수
  • 도로 차선 데이터 검수

>>> 오차율 1% 이하

portfolio2

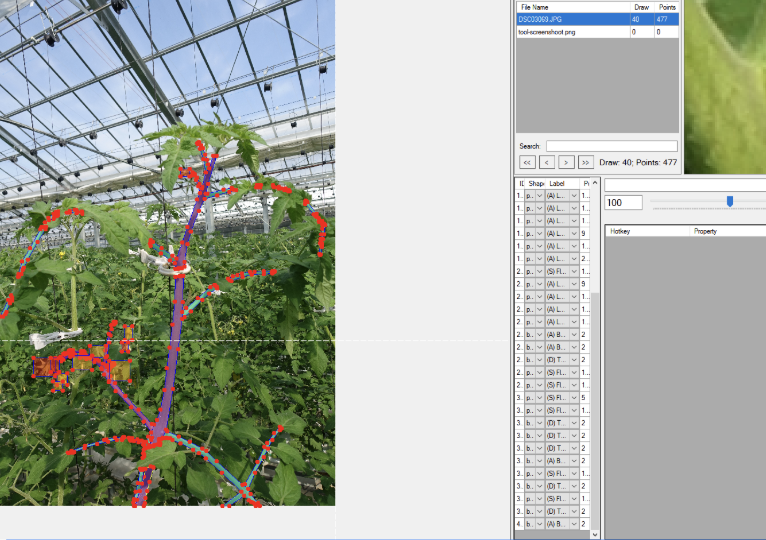
Tomatoes Annotation

SotaTek은 고객과 협력하여 이미지 내 토마토를 식별하도록 최적화된 최첨단 딥러닝 알고리즘을 개발합니다.

  • 어노테이션 대상 클래스: 토마토
  • 어노테이션 유형: 폴리곤(Polygon)

>>> 총 5,000장 이미지 작업
>>> 오차율 1% 이하
>>> 1% Error Rate
portfolio3

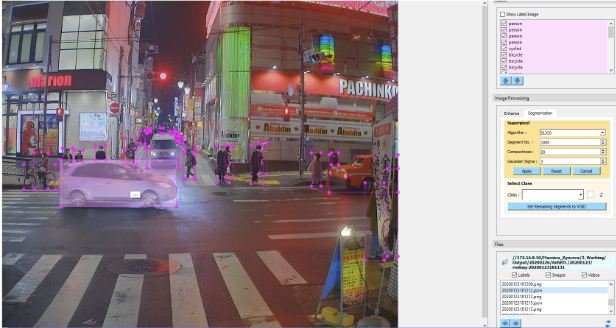
Image Annotation For ADAS

SotaTek은 일본 기업을 대상으로 차량, 보행자, 자전거 이용자(라이더) 객체에 대한 어노테이션을 수행합니다.

  • 어노테이션 대상 클래스: 차량(Vehicle), 보행자(Pedestrian) 등
  • 어노테이션 유형: 바운딩 박스(Bounding Box)

>>> 총 23,000장 이미지 작업
>>> 오차율 1% 이하

고객 후기

신뢰를 보여주는 고객 후기

더 보기 icon see more

"저희는 많은 레거시 스택을 교체해야 했고, 많은 제품 이니셔티브를 유지해야 했지만, 엔지니어링 리소스가 부족했습니다. 해당 문제 해결을 위해 해외 인력 업체를 찾던 중 소타텍을 파트너사로 선정하고 2022년 9월부터 협력했습니다. 기술적 부채를 갚는 데 도움을 주었으며 개발을 가속화했습니다. 소타텍 없이는 우리가 이렇게 많은 기술 이니셔티브를 실제로 처리할 수 없었을 것입니다. 소타텍 덕분에 시간 내에 모든 일을 처리할 수 있었습니다. 해외 엔지니어링 팀을 찾고 있다면 소타텍을 추천합니다."

wesang


Andrew Jeon

CEO - Wesang

icon-right-play-youtube

"레몬헬스케어는 대한민국을 넘어 동남아시아로 진출하기 위해 소타텍을 선택했습니다.
소타텍은 베트남에서 전문 아웃소싱 기업으로 명성을 떨치고 있습니다.
저희는 소타텍의 역량을 활용하여 스마트 병원 ERP를 동남아시아에 현지화하고 확장하며 동반 성장을 이루고자 합니다.”

Lemon-healthcare-1


Steve Hong

CEO - Lemon Healthcare

"소타텍하고 저희 웹케시 그룹이 같이 이제 힘을 합치면 굉장히 좋은 시너지가 될 것 같습니다. 소타텍은 베트남 시장에서 굉장히 빠르게 성장하고 있는 IT 기업으로서 저희하고 힘을 합치면 베트남 시장뿐만 아니라 대한민국에서 핀테크와 자원 관리 시장에 큰 영향력을 끼칠 수 있다고 판단했기 때문에 소타텍하고 저희가 협력을 하기로 결정을 했습니다. 소타텍이 가지고 있는 IT 기술 능력과 잠재력은 충분하다고 보고 있구요. 소타텍이 지금 가지고 있는 역량중에 바이링구얼 말하자면 한국어를 구사할 수 있는 인력들이 많습니다. 기술력도 중요하지만 아무튼 소타텍 직원들이 가지고 있는 한국어 역량 이 부분이 굉장히 중요한 요소인 것 같습니다."

lee sil kwon webcash ceo


Lee Sil-kwon

CEO - Webcash

icon-right-play-youtube

"오늘날 IT 서비스 제공업체의 핵심 역량은 얼마나 민첩하고 유연한지, 그리고 다른 경쟁사보다 얼마나 빠르게 변화와 혁신을 수용할 수 있는지에 달려 있다고 생각합니다. SotaTek은 매우 젊은 기업이며, 구성원들 또한 자신의 비즈니스에 대한 열정을 가지고 있습니다. 우리는 보다 활발하고 에너지가 넘치는 기업과 함께 성장하고 싶었고, 이러한 이유로 SotaTek을 전략적 파트너로 선택했습니다."

kim kiho metanet global ceo


Kim Ki Ho

CEO - Metanet

icon-right-play-youtube

업계 인사이트와 최신 정보를 확인하세요

전체 보기 icon see more

FAQ

데이터 라벨링(Data Labelling)이란 이미지, 텍스트, 음성, 영상과 같은 원시 데이터에 의미 있는 태그나 카테고리를 부여하여 머신러닝 및 AI 모델이 학습할 수 있도록 만드는 과정입니다.

라벨은 데이터에 포함된 객체나 의미(예: “자동차”, “긍정 감성”, “화자 A”)를 설명하거나, 해당 요소의 위치 정보(예: 바운딩 박스, 세그멘테이션 마스크 등)를 정의하는 역할을 합니다.

고품질 데이터 라벨링은 AI 모델의 정확도와 성능을 결정하는 핵심 요소입니다.

머신러닝 및 AI 모델은 라벨링된 데이터(정답 데이터)를 기반으로 패턴을 학습하고 예측을 수행합니다. 정확하게 라벨링된 학습 데이터가 있어야 모델이 객체, 의미, 감정, 행동 등을 올바르게 인식할 수 있습니다.

고품질 데이터 라벨링은 다음과 같은 핵심 효과를 제공합니다:

- AI 모델 정확도 향상
- 학습 시간 단축 및 개발 비용 절감
- 모델 재학습 및 반복 개선(Iteration) 속도 향상
- 실제 운영(Production) 환경에서의 오류 최소화

즉, 데이터 라벨링은 AI 모델 성능을 좌우하는 핵심 요소이며, 성공적인 AI 구축의 기반이 됩니다.

데이터 라벨링의 일반적인 예시는 다음과 같습니다:

- 이미지 내 객체에 바운딩 박스(Bounding Box) 그리기
- 의료 영상에 대한 세그멘테이션 마스크(Segmentation Mask) 생성
- 텍스트 데이터의 감성 분석(Sentiment Analysis) 및 의도 분류(Intent Tagging)
음성 데이터의 타임스탬프 기반 전사(Transcription with Timestamps)

그 외에도 다음과 같은 고도화된 데이터 라벨링 작업이 포함됩니다:

- 개체명 인식(Named Entity Recognition, NER)
- 키포인트/랜드마크 어노테이션(Keypoint/Landmark Annotation)
- 오디오 내 화자 구분을 위한 화자 분리(Speaker Diarization)

이러한 데이터 라벨링 작업은 컴퓨터 비전, 자연어 처리(NLP), 음성 인식 등 다양한 AI 모델 학습의 핵심 기반이 됩니다.

실무에서는 **데이터 라벨링(Data Labelling)**과 **데이터 어노테이션(Data Annotation)**을 거의 동일한 의미로 사용하는 경우가 많습니다.

다만, 일반적으로는 다음과 같은 차이가 있습니다:

- 데이터 라벨링: 데이터에 카테고리나 태그를 부여하는 작업을 의미하며, 주로 분류(Classification) 중심의 작업을 지칭합니다.
(예: “고양이/강아지”, “긍정/부정”, “정상/이상” 등)
- 데이터 어노테이션: 보다 넓은 개념으로, 바운딩 박스, 폴리곤, 세그멘테이션 마스크, 타임스탬프 등과 같이 위치 정보나 세부 메타데이터를 포함하는 작업까지 아우릅니다.

결론적으로 두 용어 모두 AI 학습이 가능한 데이터셋을 구축하기 위한 과정이라는 점에서 동일한 목적을 가지며, 실제 현장에서는 혼용되어 사용됩니다.

데이터 라벨의 품질은 AI 모델의 학습 결과에 직접적인 영향을 미칩니다. 부정확하거나 일관되지 않은 라벨은 모델의 학습을 왜곡시켜 낮은 정확도와 불안정한 예측 결과로 이어질 수 있습니다.

반대로, 명확한 가이드라인과 체계적인 품질 관리(QA)를 기반으로 한 고품질 데이터 라벨링은 다음과 같은 효과를 제공합니다:

- 모델 정확도(Accuracy) 향상
- 정밀도(Precision) 및 재현율(Recall) 개선
- 편향(Bias) 및 오류 감소
- 운영 환경(Production)에서의 안정성 강화

결국, 데이터 라벨링 품질은 AI 모델의 성능, 신뢰성, 그리고 전반적인 견고성(Robustness)을 결정짓는 핵심 요소입니다.